Comparatif des modèles open source 2026
Tous les prix ci-dessous sont les tarifs réels d’OpenRouter en juillet 2026, par million de tokens. OpenRouter est un agrégateur d’API qui donne accès à tous les modèles open source via une seule interface.
| Modèle | Input $/M | Output $/M | Contexte | Open source | Points forts |
|---|---|---|---|---|---|
| DeepSeek V4 Flash | 0,098 | 0,196 | 1M | Oui | Meilleur rapport qualité/prix. Mode thinking. JSON, tool calls. |
| DeepSeek V4 Pro | 0,44 | 0,87 | 1M | Oui | Le plus performant en open source. Cache hit à 0,004 $/M. |
| Qwen 3.7 Max | 1,48 | 4,43 | 1M | Oui | Flagship Qwen. Mode thinking avancé. Performance frontier. |
| GLM 5.2 (Z.ai) | 0,81 | 2,56 | 1M | Oui | Dernière génération Zhipu. Raisonnement compétitif. |
| Llama 4 Scout (Meta) | 0,10 | 0,30 | 1,3M | Oui | Contexte record 1,3M. Multimodal texte + image. |
| Kimi K3 (Moonshot) | 3,00 | 15,00 | 1M | Oui | Excellence en raisonnement long. Agentic coding. |
| NVIDIA Nemotron 3 Ultra | Gratuit | Gratuit | 1M | Oui | 550B paramètres. Disponible gratuitement sur OpenRouter. |
| Mistral Large (français) | 0,50 | 1,50 | 262K | Oui | Entreprise française. Hébergement EU natif (Scaleway, OVH). |
Source : OpenRouter API, prix relevés le 23 juillet 2026.
Pour comparer avec les modèles propriétaires : GPT-5.5 (OpenAI) coûte 2,50 $/M en input et 10,00 $/M en output. Claude Opus 4.8 (Anthropic) : 5,00 $/M et 25,00 $/M. Soit 10 à 50 fois plus cher que les modèles open source équivalents.
Quel modèle pour quelle tâche ?
Le choix dépend de ce que vous voulez faire. Voici les recommandations par cas d’usage :
Rédaction de contenu (articles, descriptions produits, emails)
- DeepSeek V4 Flash (0,098 $/M) : le meilleur rapport qualité/prix pour la rédaction en français. Produit des textes cohérents, structurés, sans halluciner.
- Llama 4 Scout (0,10 $/M) : contexte 1,3M, excellent pour résumer de longs documents en une requête. Pour découvrir 5 usages concrets de l’IA en TPE, lisez notre guide dédié.
Code et développement
- DeepSeek V4 Pro (0,44 $/M) : pour le code complexe multi-fichiers, le raisonnement sur architecture. Cache hit à 0,004 $/M.
- DeepSeek V4 Pro (0,435 $/M) : la référence pour écrire et refactorer du code multi-fichiers.
Analyse de données et RAG (chatbot sur vos documents)
- Llama 4 Scout (0,100 $/M) : contexte 1,3M de tokens. Peut ingérer un livre entier ou toute une base de connaissances en une requête.
- DeepSeek V4 Flash (0,098 $/M) : contexte 1M. Excellent pour l’analyse de gros volumes.
Raisonnement complexe (analyse stratégique, mathématiques, logique)
- Kimi K3 (3,00 $/M) : excellence en raisonnement long, capable de déduire sur de longues chaînes de logique.
- Qwen 3.7 Max (1,48 $/M) : flagship Qwen, performance frontier, mode thinking avancé.
Tâches simples et volumineuses (classification, extraction, tri)
- NVIDIA Nemotron 3 Nano (0,050 $/M) : léger, rapide, pas cher. Parfait pour traiter 10 000 emails ou classifier 1000 produits.
- Gemma 3 4B (0,050 $/M) : Google, léger, déployable en local.
Souveraineté des données (hébergement en France)
- Mistral Large (0,500 $/M) : entreprise française, hébergement natif sur Scaleway, OVH, Infomaniak.
Comment réduire les coûts ?
Même avec des modèles pas chers, la facture peut grimper si vous ne faites pas attention. Voici les leviers :
1. Le cache de prompts. DeepSeek V4 Pro propose un cache hit à 0,004 $/M en input, soit 100 fois moins cher que le prix normal. Si vous envoyez le même préambule (instructions système, contexte) à chaque requête, le cache le mémorise et ne facture quasiment plus cette partie. Gain : 50 à 80 % sur les coûts d’input pour les usages répétitifs.
2. Le routage par modèle. Ne pas utiliser un modèle frontier pour une tâche simple. Un routeur intelligent (comme OpenRouter) peut envoyer les tâches simples sur Nemotron Nano (0,050 $/M) et garder DeepSeek V4 Pro pour les tâches complexes. Gain : 5 à 10 fois sur le coût moyen.
3. Le contexte long vs multiple requêtes. Avec un modèle à contexte 1M (Llama 4 Scout, DeepSeek V4), vous pouvez envoyer toute votre base de connaissances en une seule requête au lieu de faire 50 requêtes séparées. Gain : le coût d’une requête au lieu de 50.
4. Les modèles gratuits. NVIDIA Nemotron 3 Ultra (550B), proposé sans frais sur OpenRouter, sert de banc d’essai idéal. Qwen, Llama et Gemma ont aussi des versions gratuites limitées. Pour tester ou pour un volume faible, c’est suffisant.
5. L’hébergement local. Pour les modèles légers (Gemma 3 4B, Mistral 7B, Nemotron Nano), vous pouvez les faire tourner sur votre propre serveur avec Ollama ou vLLM. Coût : l’électricité uniquement. Investissement initial : un GPU RTX 4090 (environ 1 500 €).
Comment les utiliser ?
Méthode 1 : via un agrégateur d’API (le plus simple)
OpenRouter permet d’appeler tous les modèles avec la même syntaxe REST. Vous créez un compte, vous créditez des fonds, et vous appelez n’importe quel modèle avec la même syntaxe. C’est comme utiliser l’API OpenAI, mais avec 200 modèles au lieu d’un seul. Idéal pour démarrer.
Méthode 2 : via le fournisseur direct
- DeepSeek : API directe, les prix les plus bas du marché
- Z.ai (z.ai) : API directe pour GLM, hébergé en Chine
- Scaleway (scaleway.com) : Mistral Large hébergé en France, facturation à la seconde
Méthode 3 : en local (gratuit)
Installez Ollama sur votre serveur ou votre ordinateur. Téléchargez un modèle léger (Gemma 3 4B, Mistral 7B) et interrogez-le sans connexion internet. Les données ne sortent jamais de votre machine. Idéal pour les données sensibles.
Pour une TPE qui démarre : OpenRouter avec DeepSeek V4 Flash (0,098 $/M). Pour 1000 requêtes par jour avec un contexte moyen de 2000 tokens en input et 500 en output, le coût mensuel est d’environ 12 €. Si vous utilisez WordPress, découvrez aussi 5 cas d’usage de l’IA dans WordPress.
Hébergement européen et RGPD
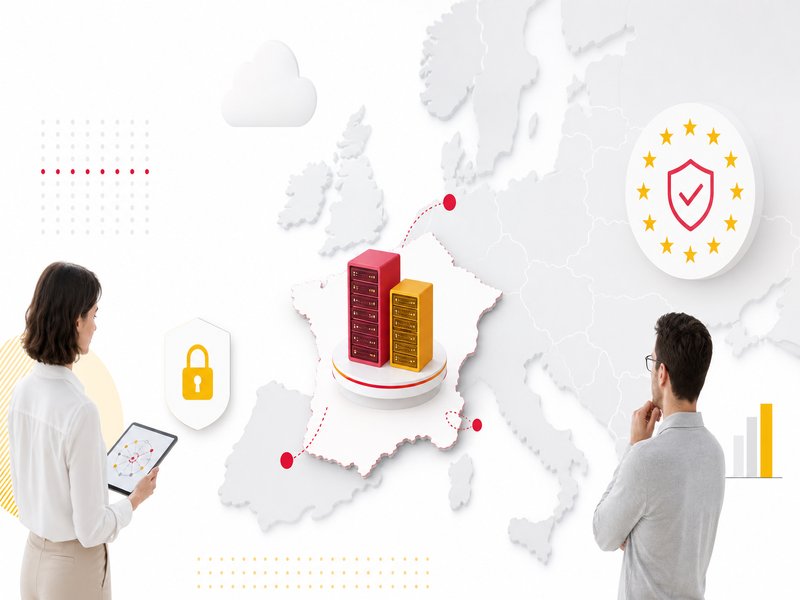
Le principal avantage de l’open source pour une entreprise française : la souveraineté des données. Avec un modèle propriétaire (OpenAI, Anthropic), vos données transitent par des serveurs américains soumis au Cloud Act. Avec un modèle open source, vous pouvez l’héberger en Europe.
Options d’hébergement européen :
- Scaleway (français) : instances GPU à l’heure, Mistral Large natif. À partir de 0,50 €/heure de GPU.
- OVHcloud (français) : instances GPU, conformité RGPD, hébergement en France.
- Infomaniak (suisse) : IA hébergée en Suisse, hors Cloud Act.
- Local : Ollama ou vLLM sur votre propre serveur pour les modèles légers.
📌 Pour aller plus loin
l’IA en entreprise : pour aller plus loin.
Quel est le modèle open source le moins cher en 2026 ?
DeepSeek V4 Flash à 0,098 $/M en input et Llama 4 Scout à 0,10 $/M. NVIDIA Nemotron 3 Ultra (550B) : gratuit, un bon point d’entrée pour tester. Pour un usage régulier, DeepSeek V4 Flash offre le meilleur rapport qualité/prix avec son cache hit à 0,004 $/M.
Les modèles open source sont-ils aussi bons que GPT-5.5 ?
Sur la majorité des tâches (rédaction, analyse, classification, résumé), oui. DeepSeek V4 Pro et Qwen 3.7 Max atteignent des scores équivalents à GPT-5.5 sur les benchmarks. Sur les tâches très complexes (raisonnement multi-étapes avancé), les modèles propriétaires restent légèrement supérieurs, mais l’écart ne justise pas un coût 10 à 50 fois supérieur.
Comment démarrer sans compétences techniques ?
Créez un compte sur OpenRouter (openrouter.ai), créditez 10 €, et utilisez l’API avec n’importe quel client HTTP. La syntaxe est identique à celle d’OpenAI. Pour un usage sans code, des interfaces comme LibreChat ou Open WebUI se connectent à OpenRouter et offrent une interface type ChatGPT avec tous les modèles open source.
Faut-il héberger le modèle soi-même ?
Pour la majorité des usages TPE, non. L’API d’un fournisseur (OpenRouter, DeepSeek direct, Scaleway) est plus simple et moins chère qu’un serveur GPU. L’hébergement local n’a de sens que pour les données hautement sensibles (données médicales, juridiques) ou pour les modèles légers (Gemma 3 4B, Mistral 7B) qui tournent sur un GPU abordable.
Mistral est-il vraiment open source ?
Mistral publie certains modèles en open weight (Mistral 7B, Mixtral, Nemo) mais garde ses modèles premium (Mistral Large, Mistral Medium) en API propriétaire. Les poids sont accessibles mais le processus d’entraînement ne l’est pas. En pratique pour une TPE, la distinction n’a pas d’impact : vous utilisez l’API, pas le modèle en local.
Combien ça coûte pour une TPE par mois ?
Avec DeepSeek V4 Flash à 0,098 $/M : pour 1000 requêtes/jour (2000 tokens input, 500 output), environ 12 €/mois. Avec le cache de prompts, 5 €/mois. À comparer aux 250 €/mois minimum pour GPT-5.5 sur le même volume. L’économie annuelle se compte en milliers d’euros.